画面越しのテキスト入力から始まった対話型AIの普及は、テキスト、画像、音声、動画、さらにはセンサーデータをひとつの頭脳で統合処理する「マルチモーダルAI」の登場によって、根本的な転換点を迎えました。単一のデータ種別しか扱えなかった従来のシステムとは異なり、人間の五感に近い知覚で文脈を把握する技術は、すでに概念実証(PoC)の域を脱し、企業の基幹業務や自動化ロボティクスの中核として実装が進んでいます。
かつては「画像認識」「自然言語処理」「音声認識」と個別モデルを組み合わせて構築していた複雑なワークフローが、ディープラーニングの大規模化とアーキテクチャの刷新によって劇的にシンプルかつ高度になりました。本稿では、マルチモーダルの基礎的な仕組みから、シングルモーダルとの決定的な違い、GPT-4oやGeminiをはじめとする2026年の最新トレンド、そして現場導入における費用対効果やリスクまでを徹底的に解剖します。
【基礎知識】マルチモーダルとは何か?シングルモーダルとの決定的な違い
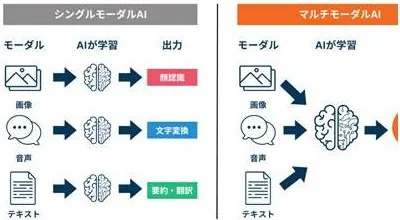
マルチモーダル(Multimodal)とは、ラテン語の「Multi(多様な)」と「Modality(様相・形式)」を組み合わせた言葉であり、IT分野においてはテキスト、静止画、動画、音声、生体データ、LiDARなどの異なる入力形式をひとつのシステムで同時に処理・理解・出力するアプローチを指します。
これに対し、従来型の主流であった「シングルモーダル(Single-modal)」は、テキストの翻訳なら自然言語処理モデル、顔認識なら画像認識モデル、文字起こしなら音声認識モデルというように、1種類のデータ形式に特化した設計となっていました。そのため、これまでのシステムで「画像内の状況を音声で解説させる」ためには、以下の多段階ステップを踏む必要がありました。
1. 音声入力を音声認識(STT)でテキスト化する
2. 画像をコンピュータビジョンで解析し、物体名をテキストタグ化する
3. 集約したテキストを大規模言語モデル(LLM)に入力して回答テキストを生成する
4. 生成されたテキストを音声合成(TTS)で音声データに変換して出力する
このパイプライン方式では、各工程を通過するたびにニュアンスやトーン、空間的な位置関係といった「言語化できない情報」がそぎ落とされ、処理遅延(レイテンシ)も肥大化するという構造的欠陥が存在しました。
対するマルチモーダルAIは、すべてのモダリティをディープラーニングによって共通の多次元空間(高次元ベクトル空間)へ直接マッピングします。「声の震えや抑揚」「背景に写るわずかな影」「文章の皮肉なニュアンス」を分離することなく丸ごと同時に解釈するため、人間が視覚と聴覚を同時に働かせて相手の意図を察知するような、極めて自然で高精度な意思決定が可能になります。
なぜ今マルチモーダルAIが爆発的に普及しているのか?技術的ブレイクスルーの真相
マルチモーダルという概念自体は十数年前から研究されていましたが、実用レベルへの到達を阻んでいたのは「計算資源の限界」と「各モダリティの統合アーキテクチャの未熟さ」でした。この壁を突き破ったのが、Transformerモデルの多次元拡張と、大規模言語モデル(LLM)から大規模マルチモーダルモデル(LMM)への進化です。
転換点となったのは、OpenAIの「GPT-4o(オムニ)」やGoogleの「Gemini」シリーズの台頭です。これらのモデルは、最初からテキスト・画像・音声を同一のニューラルネットワーク内でエンド・ツー・エンドで学習させるネイティブ・マルチモーダル設計を採用しています。中間変換を挟まないことで、対話のレイテンシは人間同士の会話と遜色ない平均300ミリ秒前後まで短縮され、画像内の細かなグラフの読み取りや、リアルタイム動画解析を通じた指示出しが可能となりました。
さらに2026年現在では、クラウド上での超巨大モデル運用だけでなく、スマートフォンやエッジデバイス上で高速動作する小型マルチモーダルモデル(SLM)の最適化が進展。通信インフラが制限される工場や医療現場、自動車内部でも、視覚・音声・センサーを即時処理する自律型エージェントの実装が本格化しています。
【徹底比較】シングルモーダル vs マルチモーダルの性能とコスト差異
導入を検討する企業にとって最も重要なのは、従来型システムやシングルモーダル構成と比較して、どのような優位性と実務上のトレードオフが存在するのかという点です。主要な項目別に実務データを比較します。
| 項目 | シングルモーダル(従来型結合) | マルチモーダルAI(統合型) | 編集部の見解・評価 |
|---|---|---|---|
| 入力対応範囲 | 1モデルにつき1種類(テキスト、音声、画像など単一) | テキスト・画像・動画・音声・センサー値を同一に入力可能 | 現場データの大半を占める「非構造化データ」をそのまま活用できる点が最大の強み。 |
| 応答レイテンシ | 1.5秒〜3.5秒(多段APIパイプラインによるオーバーヘッド大) | 0.2秒〜0.6秒(単一モデル内で即時推論) | コールセンターのリアルタイム応対や現場作業アシスタントにおいて決定的な差を生む。 |
| 文脈・ニュアンス理解 | テキスト化された情報のみ。声色や表情、微細な配置は消失 | 視線、声のトーン、図表のレイアウト構造を一体として認識 | 「これ」「そこ」といった指示語の指す対象を画像から正確に特定可能。 |
| システム保守・運用性 | 各専門モデルの個別管理、API連携のメンテナンス負担高 | 統合モデルのエンドポイント管理に集約され保守工数は低下 | 運用は簡素化される一方、特定モダリティのみの微細チューニングには独自ノウハウが必要。 |
| トークン・推論コスト | テキスト主体のため比較的低コストで予測しやすい | 画像(高解像度)・音声・動画の入力により消費リソースが増加 | 2026年はトークン単価の低廉化が進むも、動画フレーム単位の処理設計を怠るとコスト急増のリスクあり。 |
【2026年最新動向】現場で起きているビジネス活用事例と業務変革のリアル
マルチモーダルAIの真価は、デスクワークの文章作成支援にとどまらず、物理空間を伴う産業現場のオートメーションにおいて発揮されています。国内の主要産業における実装事例を整理します。
1. 製造・プラント現場における「複合異常検知と遠隔保全」従来の画像検査カメラでは見逃されていた微細な亀裂や、異音マイクだけでは判別できなかった機械トラブルに対し、サーモグラフィ画像、稼働音の周波数データ、振動センサーの数値を同時入力して異常度を診断するシステムが導入されています。作業員がウェアラブルカメラを装着して機器を見つめ、「このバルブの締め付けトルクは?」と口頭で問いかけるだけで、マニュアルの該当箇所と照合したAR指示が視界に即座に投影される環境が標準化しつつあります。
2. 医療・ヘルスケアにおける「マルチモーダル診断支援」電子カルテの問診テキスト、血液検査の数値データ、CTやMRIの画像データ、さらには患者の表情や呼吸音をひとつのAIモデルで統合解析する実証研究が急速に進展しています。単一の画像所見だけでは特定が困難だった初期疾患の兆候を、バイタルデータの変動履歴と結びつけて医師にアラートを出すことで、見落としリスクの低減と問診時間の短縮を両立させています。
3. コンタクトセンター・営業における「リアルタイム感情・意図解析」顧客の通話音声から「声のトーンや話速」を捉えつつ、共有されている画面の操作ログやチャット履歴を並行して解析。顧客の焦燥感や不満の度合いをスコアリングし、オペレーターに最適な提案スクリプトをリアルタイム表示する仕組みがカスタマーサポート現場の離職率低下と応対品質向上に寄与しています。
一般に知られていない盲点とネットの誤解
急速な普及の裏で、マルチモーダルAIに対する過度な期待や認識の誤りによるトラブルも報告されています。導入にあたって排除すべき代表的な3つの誤解を検証します。
誤解1:「あらゆるデータをそのまま投げ込めば万能の回答が出る」マルチモーダルモデルは柔軟な入力に対応しますが、入力データの質(解像度、ノイズ比率、アノテーションの整合性)に依存する点は従来の機械学習と変わりません。特に、不鮮明な現場写真や雑音が混入した音声データを前処理なしでそのまま投入した場合、モデルがもっともらしい虚偽を出力する「マルチモーダル・ハルシネーション」が発生しやすくなります。入力データの正規化とコンテキストの絞り込みは依然として必須の技術要件です。
誤解2:「すべての業務をマルチモーダルに置き換えるべきである」単純なテキスト要約や定型フォーマットのデータ抽出など、単一モダリティで完結する業務にマルチモーダルモデルを適用することは、推論コスト(トークン消費量やサーバー負荷)の観点から明白な過剰投資となります。「視覚情報とテキストの照合が不可欠な領域」に限定してマルチモーダルを配備し、定型処理は軽量な専用モデルに任せるハイブリッド設計が費用対効果を最大化する鉄則です。
誤解3:「マルチモーダルならセキュリティと著作権の問題は自動でクリアされる」画像や音声の取り扱いには、従来のテキスト以上に厳密なプライバシー管理が大切です。防犯カメラ映像や作業員の生体情報、音声録音データをクラウドモデルに入力する際のデータガバナンス(学習への利用拒否設定やローカル環境での閉塞処理)を怠ると、深刻なコンプライアンス違反を招く恐れがあります。
【プロの結論】導入で成果を出す現場・慎重になるべき現場の判断基準
生成AI活用が第2フェーズに入った現在、マルチモーダルAIの導入で確実な投資対効果(ROI)を創出できる組織と、実証実験止まりで撤退する組織の間には明確な分水嶺が存在します。
積極的にマルチモーダルAIを採用すべき現場- 「熟練者の暗黙知」が視覚や聴覚に依存している業務:熟練工の目視点検、機器の異音判別、医療画像の初期スクリーニングなど、言語化が困難だったノウハウのデジタル化を推進したい領域。
- リアルタイム性が顧客体験や現場安全に直結するシーン:対面接客ロボット、ハンズフリーの倉庫ピッキング指示、建設現場での危険行動検知など、0.5秒以内の統合フィードバックが求められる業務。
- 非構造化ドキュメントの処理比率が高いバックオフィス:手書きメモ、図面、領収書、グラフ入り報告書が混在し、テキストOCRだけでは正確な情報抽出が困難だった帳票処理フロー。
- 推論処理のミリ秒単位の決定論的正確性が絶対条件となる制御系:モデル内部の推論プロセスがブラックボックス化しやすいため、ミリ秒単位での100%の再現性が求められる産業ロボットの直接駆動系には、既存の制御ロジックとの二重化が不可欠です。
- ネットワーク帯域やハードウェアスペックが極めて貧弱な環境:高解像度動画や音声ストリームの継続的な送受信は通信コストを圧迫します。エッジ側でのフレーム間引きや軽量モデルでの事前フィルタリング設計が整っていない場合はインフラ整備が先行課題となります。
【マルチ モーダル と は】に関するよくある質問(FAQ)
Q1:マルチモーダルAIとLLM(大規模言語モデル)の具体的な違いは何ですか?
A1:LLMは主に「テキスト(文字列)」の並びを予測・生成することに特化したモデルです。一方、マルチモーダルAI(LMM)は、LLMの推論能力をベースにしながら、画像、音声、動画などの異なるデータ形式を共通の内部表現(埋め込みベクトル)として直接理解・処理できるように拡張したモデルを指します。
Q2:マルチモーダルAIを利用する際のコストはシングルモーダルより高くなりますか?
A2:画像や音声の入力はテキストと比較して「計算量(トークン換算)」が多くなるため、1回あたりの処理単価は高くなる傾向があります。ただし、複数の単機能AIを組み合わせていたパイプラインの構築・保守工数やサーバー集約効果を考慮すると、システム全体のトータルコスト(TCO)ではマルチモーダル統合の方が安価に収まるケースが増えています。
Q3:社内データを活用したマルチモーダルAIのカスタマイズ(RAGやファインチューニング)は可能ですか?
A3:可能です。現在は画像とテキストをセットで検索するマルチモーダルRAG(検索拡張生成)技術が確立されており、社内のPDF図面や取扱説明書、商品カタログを画像配置やレイアウト構造を保ったままベクターデータベースに格納し、高精度に参照・回答させることが可能になっています。
マルチモーダルAIの本質は、単に扱えるファイル形式が増えたことではなく、AIが「人間と同じ世界の捉え方」を獲得したことにあります。テキストという抽象記号の制約から解き放たれ、視覚や聴覚を通じた空間的・時間的な文脈を理解できるようになったことで、AIの適用領域はデジタル空間から物理空間のオペレーションへと決定的な広がりを見せています。
企業がこの技術革新を自社の競争力へ転換するためには、ツールとしての性能比較にとどまらず、「どの現場業務において視覚や音声の文脈がボトルネックになっているか」を正確に見極める業務解像度が問われます。過剰な期待とコストリスクを冷静に見極めつつ、五感を備えた次世代AIを前提としたビジネスプロセスの再構築に着手することが、今後のデジタル変革を勝ち抜く鍵となります。